交稿前一天,你把论文从头读了一遍,发现正文里写的均值和表格里的数字对不上——差了 0.03。你翻回 SPSS 输出,又翻原始 Excel,花了四十分钟才确认是哪一步复制粘贴时少选了一行。这种事不是偶尔发生,而是几乎每篇论文都会经历一次。
数字核对这件事,麻烦不在于它难,而在于它枯燥到让人走神。正文、表格、图注、摘要,同一个数字可能出现在四个地方,改了一处忘了另一处。更常见的情况是:数据在分析阶段反复筛过几版,最后写进稿子的到底是哪一版,连自己都不确定。
只靠一遍通读,几乎必然会漏
很多同学的核对方式是:打印出来,拿笔逐行读。这不是坏习惯,但有两个结构性问题。
第一,人的眼睛会「补全」。你对这篇稿子太熟了,读到「均值为 3.42」时,大脑直接跳过,因为它期待看到这个数字。真正的错误往往藏在你最熟悉的句子里。
第二,通读的逻辑是线性的,但数字的一致性是网状的。正文第三章提到「样本量为 N=218」,附录表 A 的脚注写的是「N=281」,这两处在通读时根本不会自然相遇。你需要的不是读一遍,而是专门针对每一个数字做一次「全文搜索式比对」。
还有一个常见误区:把描述统计的核对和数字一致性的核对混在一起做,结果两件事都做得不彻底。前者是「这个均值算对了吗」,后者是「这个均值在全文各处写的是同一个数吗」。这是两个不同的任务,分开做才不会互相干扰。
一套可以照做的数字自检流程
下面这套流程我自己用了几篇论文,基本能把明显的数字错误拦住。不是万能的,但比通读靠谱。
第一步:列出「数字清单」(建议在分析结束后立刻做)
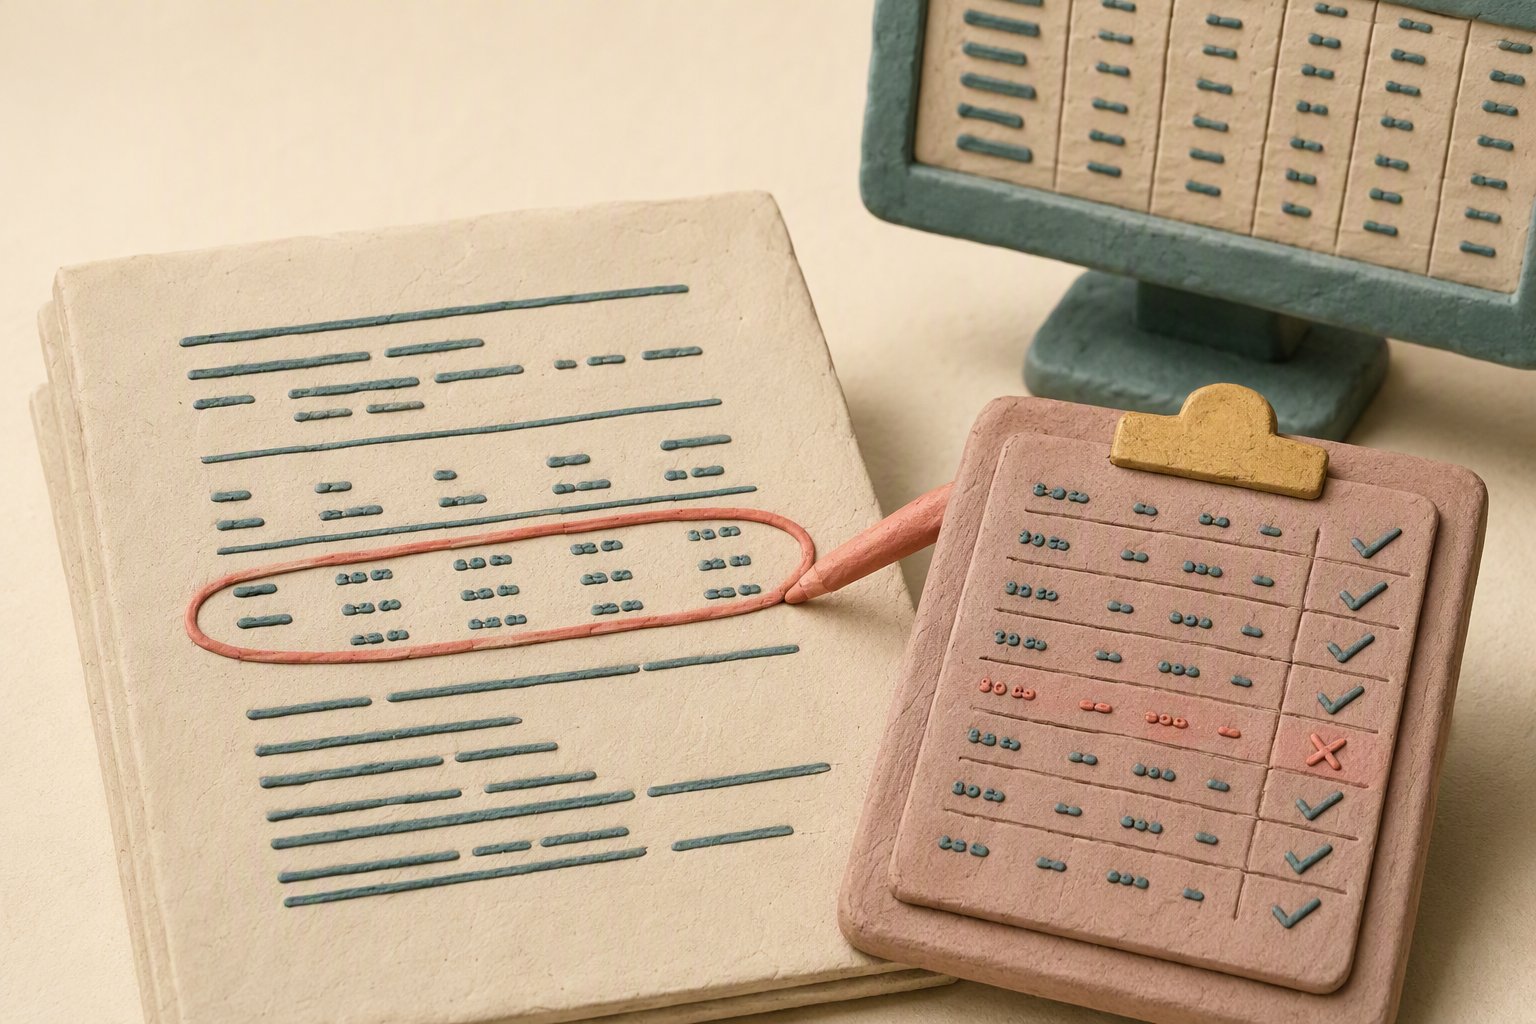
打开一个新的表格文件,把你分析得出的所有关键数字抄进去:样本量、各组 N、均值、标准差、相关系数、显著性 p 值、效应量等。每个数字对应一行,标注它来自哪个分析文件的哪个输出。这份清单是后续核对的「真值表」,后面所有出现在稿子里的数字都要对照这里。
第二步:全文「数字提取」
用 Word 或 PDF 的查找功能,逐一搜索你清单里的每个数字(或其关键词,如「N =」「p <」「M =」),把它出现的所有位置标出来。不要依赖通读,要主动去找。摘要、引言、方法、结果、讨论、图注、表格脚注,每一处都算。
第三步:逐条比对,打勾或标红
对照第一步的清单,把第二步找到的每一处数字和清单核对。一致就打勾,不一致就标红并注明差异。这一步不要急着改,先全部标完再统一处理,避免改了一处又漏掉另一处。
第四步:检查单位和表述
数字对上了不代表没问题。「均值 3.42 分(5 分制)」和「均值 3.42(满分 7 分)」是完全不同的意思。逐一检查每个数字旁边的单位、量表说明、括号内容,确认和原始分析一致。
第五步:图表与正文交叉核对
把每张图、每张表单独列出来,检查:图题/表题是否和正文描述一致?图中的坐标轴标签、图例和正文说法是否对得上?表格里的列名和正文里提到的变量名是否统一?这一步容易被忽略,但图表和正文打架是审稿人最容易发现的问题之一。
第六步:让别人或工具「陌生眼」过一遍
自己核对有盲区,因为你太熟悉这篇稿子了。找同学帮你读一遍结果部分,或者把稿子放两天再回来读。如果时间紧,可以用工具辅助——下一段会讲具体怎么做。
把「真值表 + 稿件」一起丢进去,补「陌生眼」
上面的方法论里,最难坚持的是第六步——找一个真正「陌生」的视角来审你的数字。同学不一定有空,自己放两天再看又太慢。时间紧的时候,可以把「真值表」和结果部分文稿一起丢进 DiffMind 的对比模式,让两个模型各自扮演没读过稿的读者来挑错。
1. 打开对比模式,在对话输入区上传两份材料:结果部分文稿(或整章 Word/PDF),以及你的「数字清单」。
2. 需要的话点一下输入区的「提问增强」,把「帮我看看数字对不对」收成更具体的指令,再发送。
3. 选两个模型同时跑同一条核对问题,并排看它们各自标出的不一致处——漏检集合往往不完全重叠。
4. 把两边标红的条目抄回你的清单,自己回原始分析文件改;工具只负责挑错,不负责改数。
示例 1(数字一致性核对)
> 我上传了论文结果部分文本和一份数字清单。请逐一检查文本中的均值、标准差、样本量、p 值等,与清单比对,列出所有不一致处(位置 + 具体差异)。不要改写正文。
示例 2(图表与正文交叉核对)
> 以下是第三章正文和表格内容。请检查正文中的变量名、数值与表格列名、数值是否一致;有出入请逐条列出。
示例 3(单位与量表说明核对)
> 请检查以下文本中每处数字是否都有明确单位或量表说明,并指出模糊或与上下文不一致的地方。
这不是替代自检清单,而是给第六步加一层「外部挑错」。真正改数字时,仍以你自己的真值表为准。
数字错误不丢人,但可以提前拦住
数字出错不代表研究做得差,很多时候只是分析和写作之间的信息传递断了一环。真正让审稿人皱眉的,是那种「明显没有认真自查」的错误——同一个数字在不同地方写法不一样,或者图表和正文直接矛盾。
把上面的自检清单走一遍,再在 DiffMind 对比模式里把文稿和数字清单一起上传,做一轮「陌生眼」挑错,大部分这类问题能在交稿前拦住——不用改你现有工作流,只是在最后加一道关。